


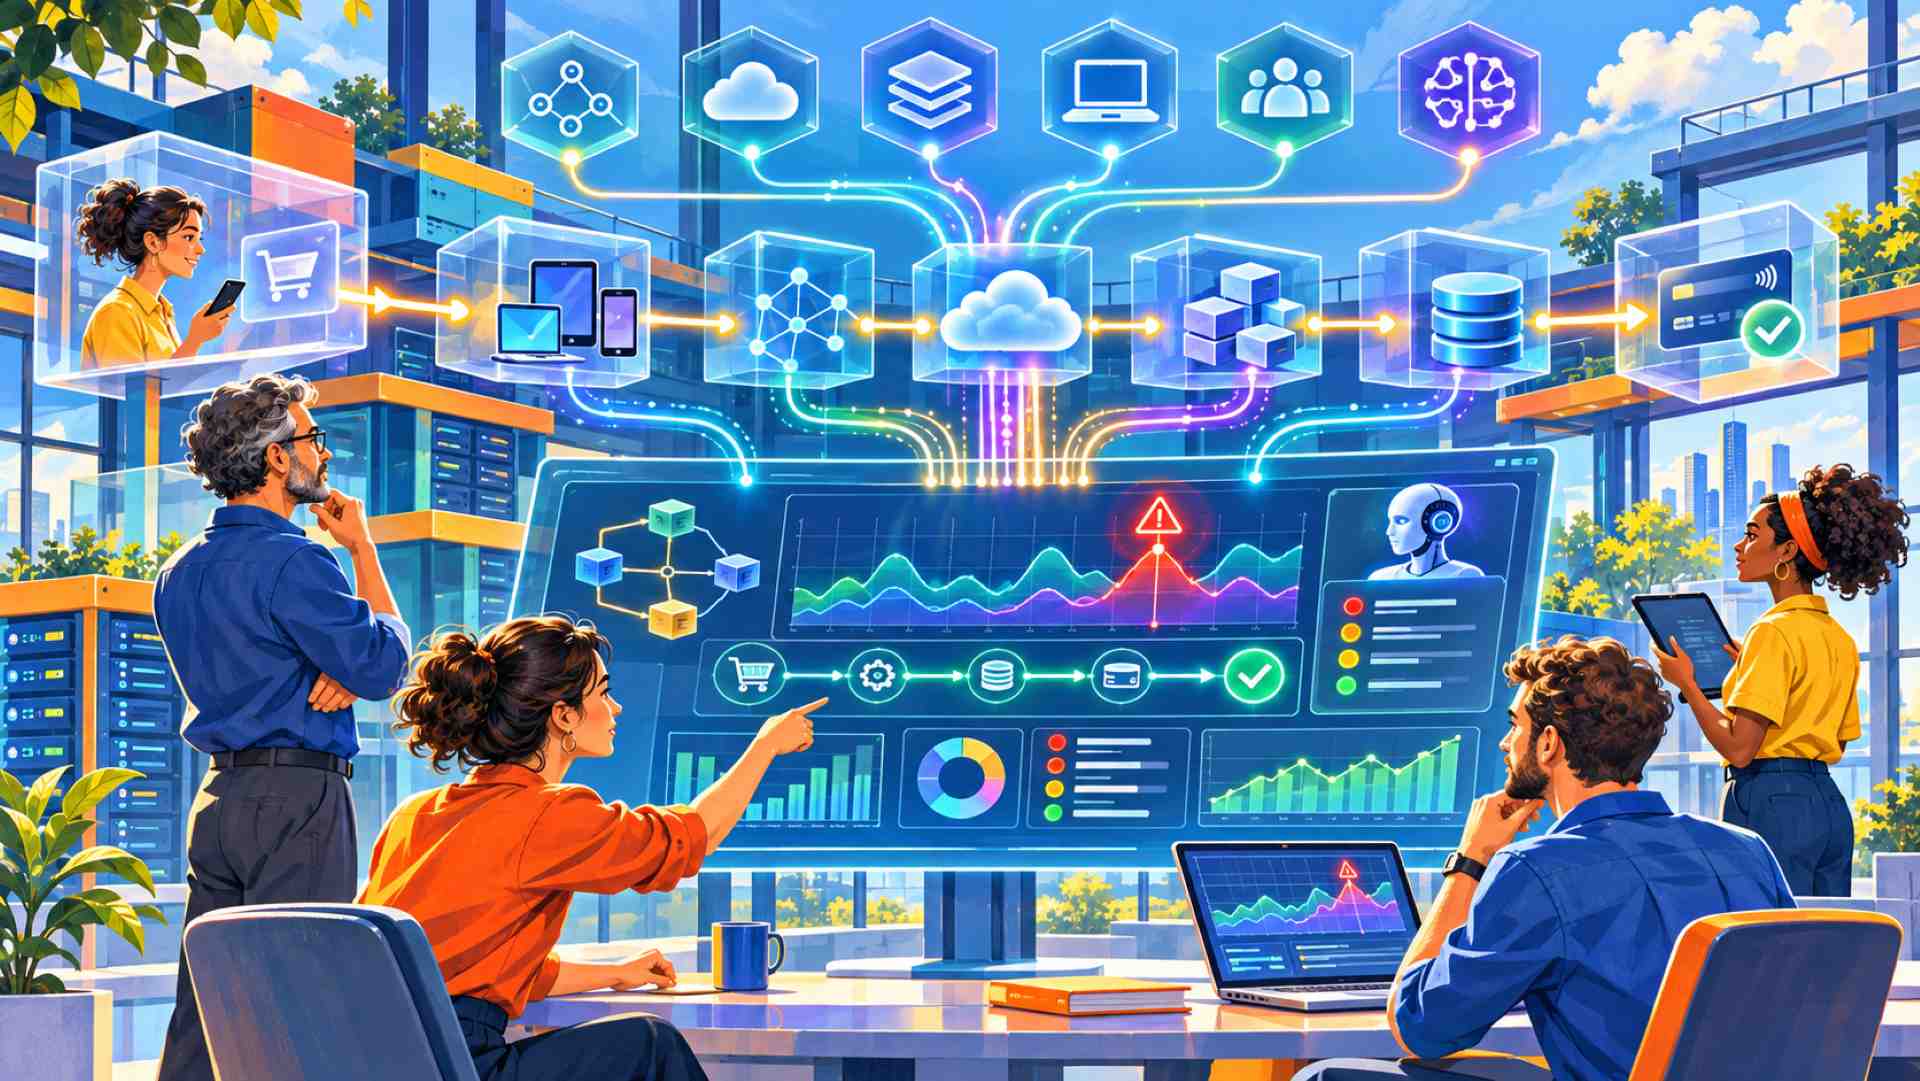
L’observability non è più solo una disciplina DevOps. Se in passato era utilizzata soprattutto per monitorare applicazioni e infrastrutture IT, oggi rappresenta uno strumento strategico per i CIO perché offre una visione unificata di reti, cloud, endpoint, applicazioni e digital employee experience.
Il suo valore risiede nella capacità di mettere in relazione questi ambienti, consentendo di individuare l’origine di rallentamenti e anomalie, capire quali servizi sono coinvolti e valutarne l’impatto sulle attività degli utenti.
Alla base di questa visibilità c’è la telemetria, ovvero l’insieme dei dati generati dai sistemi durante il loro funzionamento. Come spiega l’introduzione all’osservabilità di OpenTelemetry, metriche, log e tracce distribuite costituiscono i principali elementi su cui si fonda l’osservabilità: le metriche misurano indicatori come tempi di risposta ed errori, i log registrano gli eventi e le tracce seguono il percorso di una richiesta attraverso componenti e servizi differenti. Analizzati in modo correlato, questi dati permettono di comprendere non solo che cosa sta accadendo, ma soprattutto perché accade, anche quando si verificano problemi inattesi.
Indice degli argomenti
Collegare le performance IT ai risultati di business
Il collegamento fra observability e business non nasce automaticamente dai dati. Per attribuire una priorità a un problema non basta sapere che esiste un rallentamento: occorre capire quali attività sono coinvolte, chi ne è impattato e quali conseguenze può avere sul risultato finale. La telemetria acquista quindi valore quando viene messa in relazione con servizi, processi e obiettivi aziendali.
Per costruire questo collegamento, le direzioni IT possono concentrarsi su tre aspetti fondamentali: la mappatura dei processi e delle relative dipendenze tecnologiche, la definizione di indicatori legati ai risultati attesi e l’assegnazione di responsabilità lungo l’intera catena del servizio.
- Mappare applicazioni e processi. Il primo passo consiste nel ricostruire il percorso che sostiene un’attività di business. Nel caso di un acquisto online, ad esempio, il processo comprende il carrello, la verifica delle disponibilità, l’autenticazione dell’utente, il pagamento e la registrazione dell’ordine. A ciascuna fase vanno associati applicazioni, API, database e servizi esterni, identificando anche le dipendenze condivise. La mappa deve riflettere il percorso effettivamente seguito dalle richieste, compresi errori, eccezioni e tentativi ripetuti, così da evidenziare con precisione quali processi potrebbero essere coinvolti da un malfunzionamento.
- Scegliere gli indicatori a partire dal risultato atteso. Il secondo passaggio riguarda gli indicatori. Il punto di partenza non è la tecnologia, ma il risultato atteso: che cosa significa completare correttamente un’attività? Nel caso di un pagamento online possono essere rilevanti il numero di transazioni concluse con successo, il tempo necessario per completarle e il tasso di abbandono. Metriche tecniche come latenza delle API o errori del database restano importanti, ma soprattutto perché aiutano a spiegare eventuali peggioramenti delle prestazioni percepite dagli utenti. Il Google SRE Workbook, nel capitolo Implementing SLOs, suggerisce di scegliere pochi indicatori rilevanti per gli utenti e concordare gli obiettivi con i soggetti coinvolti. Per ogni indicatore conviene fissare formula, fonte dei dati, periodo di osservazione e soglia che richiede attenzione, così da rendere confrontabili le misure.
- Assegnare responsabilità sul servizio completo. Infine, è necessario definire responsabilità chiare. Chi risponde del risultato del processo deve poter collaborare con chi gestisce le applicazioni, le infrastrutture e i dati. Una ripartizione chiara dei ruoli consente di stabilire chi riceve gli allarmi, chi coordina la risposta agli incidenti e quando un problema richiede un’escalation verso livelli decisionali superiori.
L’esempio del pagamento online mostra perché questi tre elementi debbano procedere insieme. Un servizio può risultare tecnicamente disponibile e, allo stesso tempo, generare tempi di risposta tali da compromettere l’esperienza degli utenti. In questi casi, sapere che il sistema è operativo non basta: conta capire quante transazioni vengono completate, quante richiedono nuovi tentativi e quante vengono abbandonate.
Quando mappatura, indicatori e responsabilità sono stati definiti correttamente, l’observability consente di collegare il sintomo alla sua causa e al relativo impatto di business. La mappa aiuta a individuare la dipendenza responsabile del rallentamento, gli indicatori mostrano se il problema sta influenzando il risultato atteso e i ruoli assegnati permettono di intervenire rapidamente con le persone giuste.
Come collegare applicazioni, processi e decisioni
| Passaggio | Che cosa definire | A che cosa serve |
|---|---|---|
| Mappatura | Per ogni passaggio: applicazioni, dati, dipendenze e processo sostenuto | Seguire il disservizio fino alle componenti coinvolte |
| Indicatori | Esito atteso, formula, dati di origine, periodo e soglia | Misurare il degrado del servizio e la sua evoluzione |
| Responsabilità | Referente del processo, responsabile del servizio, team tecnici ed escalation | Assegnare l’intervento e autorizzare le azioni necessarie |
L’AI aiuta a individuare i segnali che richiedono attenzione
È È proprio in questa attività di selezione, correlazione e interpretazione dei dati che si inserisce l’AI applicata all’observability. La crescente quantità di telemetria generata da infrastrutture, applicazioni, reti ed endpoint rende infatti difficile distinguere rapidamente i segnali rilevanti dal rumore di fondo. L’obiettivo dell’intelligenza artificiale è aiutare i team IT a individuare più velocemente gli eventi che meritano attenzione, riducendo il numero di avvisi da analizzare manualmente.
Attraverso la correlazione di informazioni provenienti da fonti diverse, i sistemi di AI possono individuare relazioni che sarebbero difficili da cogliere osservando i singoli eventi in modo isolato. Un aumento dei tempi di risposta di un’applicazione, per esempio, può essere collegato a errori in un servizio dipendente, a una modifica recente dell’infrastruttura o a un nuovo rilascio software. L’analisi dei comportamenti storici consente inoltre di evidenziare anomalie rispetto ai modelli abituali e di ridurre il numero di falsi allarmi. Il risultato non è una diagnosi definitiva, ma un insieme di evidenze e possibili cause che orientano il lavoro di analisi.
Per il CIO, il valore di queste capacità si misura soprattutto nei risultati: la rapidità con cui vengono individuati i disservizi, il tempo necessario per identificare le componenti coinvolte e la capacità di ripristinare il servizio limitando le attività manuali.
Il numero di alert generati, preso isolatamente, rappresenta infatti un indicatore poco significativo. Più importante è capire quanti avvisi si traducono in interventi efficaci e quanti problemi continuano a sfuggire ai meccanismi di rilevazione. Per questo motivo, le correlazioni e le ipotesi prodotte dagli strumenti devono rimanere verificabili attraverso dati, tracce e dipendenze osservabili.
L’automazione può spingersi oltre l’identificazione delle cause, arrivando a suggerire o perfino ad avviare azioni correttive. Quanto più aumenta il livello di autonomia, tuttavia, tanto più diventa importante mantenere meccanismi di supervisione e controllo. Il tema assume particolare rilevanza quando l’intelligenza artificiale entra direttamente nei processi aziendali che devono essere monitorati, operando attraverso agenti, modelli e strumenti integrati nei flussi di lavoro. In questi contesti, l’observability non serve soltanto a comprendere il comportamento dei sistemi, ma anche a garantire trasparenza e controllo sulle decisioni e sulle azioni intraprese dall’AI stessa.
Agenti AI: che cosa diventa necessario osservare
Con i sistemi basati su agenti AI, l’osservabilità assume una dimensione ulteriore. Un agente può recuperare informazioni da diverse fonti, interrogare applicazioni aziendali, utilizzare strumenti esterni e impiegarne i risultati per avviare nuove attività.
Comprendere che cosa è accaduto richiede quindi la possibilità di ricostruire l’intera sequenza operativa: quali fonti sono state consultate, quali strumenti sono stati utilizzati, dove si sono verificati errori o rallentamenti e in quali punti è stato necessario l’intervento umano.
La guida Inside the LLM Call: GenAI Observability with OpenTelemetry illustra come raccogliere segnali sulle chiamate ai modelli e agli strumenti, sui tempi di esecuzione e sul consumo di token.
La ricostruzione del flusso consente, ad esempio, di distinguere un ritardo causato dal modello da uno dovuto a un servizio esterno o a una catena di operazioni particolarmente complessa. L’obiettivo non è soltanto identificare un’anomalia, ma localizzare con precisione il punto in cui il processo perde efficienza o si interrompe.
L’analisi, però, non può fermarsi agli aspetti tecnici. Quando un agente supporta o automatizza un processo aziendale, conta soprattutto la qualità del risultato prodotto. Nel caso di una pratica amministrativa, ad esempio, è possibile valutare se le informazioni raccolte sono complete, se i dati corrispondono alle fonti disponibili e quanto frequentemente si renda necessario un intervento correttivo da parte di una persona. Per questo motivo gli indicatori operativi devono essere collegati a una definizione condivisa di attività completata correttamente.
Lo stesso principio vale per la misurazione dei costi. Il consumo di token rappresenta soltanto una delle componenti da considerare: al costo complessivo possono contribuire anche servizi esterni, infrastrutture, strumenti software e attività di controllo umano. Di conseguenza, il parametro più significativo non è il costo della singola interazione, ma il costo necessario per completare con successo un’attività e ottenere un risultato accettabile. Una configurazione apparentemente più economica può infatti richiedere più tentativi, generare più verifiche o produrre un numero maggiore di errori da correggere.
Accanto a prestazioni, qualità ed efficienza economica, rimane infine il tema della protezione dei dati. Tracciare il comportamento degli agenti significa spesso raccogliere informazioni relative a prompt, richieste e contenuti elaborati, che possono includere dati sensibili o riservati.
Per questo la progettazione dell’osservabilità deve procedere insieme alla definizione delle politiche di accesso, protezione e conservazione delle informazioni. La trasparenza dei processi AI non può infatti prescindere dalla corretta gestione dei dati che li alimentano.
Le principali soluzioni di observability sul mercato
Questi criteri possono essere utili anche per interpretare l’offerta del mercato. Le piattaforme di observability stanno infatti ampliando il proprio raggio d’azione oltre il monitoraggio tradizionale, integrando funzionalità di analytics avanzate, ottimizzazione dei costi e strumenti basati sull’intelligenza artificiale. In questo senso, il Magic Quadrant for Observability Platforms di Gartner, ha valutato l’evoluzione del mercato attraverso analytics, gestione dei costi e AI. Le otto soluzioni che seguono, in ordine alfabetico, appartengono al perimetro dei fornitori esaminati: una selezione per orientare il confronto, da restringere in base ai servizi aziendali da osservare.
Coralogix
Coralogix riunisce log, metriche, tracce e altri segnali in un Telemetry Lake. L’offerta comprende analisi applicativa, monitoraggio dell’esperienza utente e telemetria AI; il modello descritto dal produttore utilizza anche object storage nel cloud del cliente. Il suo elemento da approfondire nel confronto è la gestione del ciclo di vita della telemetria, dalla raccolta alle interrogazioni sui dati conservati.
Datadog
Datadog propone una piattaforma SaaS con monitoraggio di infrastrutture, reti, container, database e applicazioni, affiancato da log management e analisi dell’esperienza digitale. Il catalogo include osservabilità degli agenti e gestione dei costi cloud. Per il CIO l’interesse è nella copertura di più domini operativi; la verifica economica deve individuare quali moduli e volumi servano al perimetro scelto.
Dynatrace
Dynatrace combina osservabilità infrastrutturale e applicativa, esperienza digitale, log e business observability. La mappatura Smartscape ricostruisce le relazioni tra applicazioni e infrastruttura; Grail raccoglie e rende analizzabili i dati. L’elemento da valutare è l’uso del contesto delle dipendenze nell’indagine e nell’automazione, verificandolo su un percorso di servizio rappresentativo dell’azienda.
Elastic Observability
Elastic Observability integra analisi dei log, metriche, monitoraggio applicativo e tracce distribuite, con funzioni per l’esperienza digitale e le applicazioni AI. Supporta OpenTelemetry e prevede opzioni cloud e autogestite. Il confronto può concentrarsi su ricerca e analisi trasversale dei segnali, considerando anche le competenze e le risorse necessarie per la modalità di gestione prescelta.
Grafana Cloud
Grafana Cloud è l’offerta gestita di Grafana Labs, che combina osservabilità, risposta agli incidenti e strumenti AI in una piattaforma basata su OpenTelemetry. Include funzioni per selezionare la telemetria e osservare gli agenti. È una proposta da esaminare quando contano integrazione con standard aperti e controllo dei dati raccolti, verificando quanto del percorso applicativo sia effettivamente coperto.
IBM Instana Observability
IBM Instana Observability punta sulla scoperta e sulla strumentazione automatica di applicazioni e infrastrutture, con ricostruzione delle dipendenze e analisi delle transazioni. L’offerta comprende osservabilità di modelli e agenti AI e supporto a OpenTelemetry. Il punto da verificare è la profondità della visibilità applicativa sulle tecnologie presenti in azienda e il collegamento tra i diversi componenti del servizio.
New Relic
New Relic riunisce monitoraggio applicativo, infrastrutture, log, esperienza digitale e sistemi AI. La piattaforma prevede l’integrazione con dati di business e supporta standard di raccolta come OpenTelemetry. Il confronto può partire da come vengono collegati transazioni e risultati operativi, provando su casi reali la navigazione dal segnale del processo alla componente tecnica coinvolta.
Splunk Observability Cloud
Splunk Observability Cloud offre monitoraggio applicativo e infrastrutturale, analisi dell’esperienza utente e funzioni per gli agenti AI. Utilizza OpenTelemetry e permette di consultare nel contesto dell’indagine i log già presenti nella Splunk Platform. L’aspetto da approfondire è la continuità dell’analisi tra segnali e ambienti, verificando perimetro delle integrazioni e componenti richieste.
Da quale servizio partire
La scelta di una piattaforma di observability e l’avvio di un primo progetto dovrebbero partire da un servizio per il quale siano chiaramente identificabili utenti, risultato atteso e conseguenze di un’interruzione. L’obiettivo non è monitorare tutto fin dall’inizio, ma concentrarsi su un’attività il cui valore per il business sia facilmente comprensibile.
Il Microsoft Azure Well-Architected Framework, nella raccomandazione RE:02, propone di distinguere i percorsi compiuti dagli utenti dai flussi interni di dati e operazioni. Raccomanda di documentarne inizio, fine, dipendenze, responsabili ed escalation, quindi assegnare una criticità sulla base delle conseguenze per il business. Un servizio condiviso può richiedere particolare attenzione perché il suo guasto coinvolge più processi.
Una volta definito il servizio da analizzare, il passo successivo consiste nell’individuare i flussi più rilevanti e misurarne prestazioni, errori e volumi operativi (si veda ad esempio la raccomandazione Microsoft PE:09, dedicata alle prestazioni dei flussi critici). Non tutti i processi hanno infatti la stessa importanza: alcuni sostengono attività centrali per l’azienda e richiedono quindi livelli di attenzione, risorse e protezione superiori. In presenza di vincoli infrastrutturali può essere opportuno riservare capacità dedicata ai servizi più importanti oppure introdurre meccanismi di priorità che ne garantiscano il corretto funzionamento anche nei momenti di maggiore carico.
La logica di fondo è semplice: la rilevanza del processo deve guidare sia le decisioni operative sia il livello di dettaglio con cui raccogliere e analizzare i dati di osservabilità. È da questo collegamento tra dati operativi e risultati di business che l’observability ricava il suo valore strategico per il CIO.


























Partecipa alla community