


Nelle infrastrutture aziendali, individuare un’anomalia prima che si traduca in un’interruzione di servizio richiede spesso di correlare telemetria, configurazioni e dati distribuiti su piattaforme diverse. E quest’ambito l’intelligenza artificiale sta cambiando l’approccio: è in grado di mettere in relazione segnali apparentemente scollegati, ricostruire le dipendenze tra sistemi e suggerire, o in alcuni casi eseguire direttamente, le azioni correttive necessarie.
Il percorso verso le “reti autonome” sposta il focus del network management oltre il semplice controllo degli apparati. Alla domanda “quale componente sta causando il problema?” si affianca infatti un interrogativo più vicino al business: “quale processo aziendale ne sta subendo le conseguenze?”.
Si tratta di una trasformazione ancora in corso e con livelli di maturità differenti: molte attività operative e ripetitive possono già essere automatizzate, mentre le decisioni più critiche continuano a richiedere supervisione umana, regole di governance e meccanismi di controllo.
Indice degli argomenti
L’AI rende la rete più intelligente, ma a cambiare sono soprattutto gli strumenti
“La rete non è il cervello, ma il sistema nervoso”. La metafora descrive bene il ruolo di un’infrastruttura che raccoglie e trasmette segnali dal campo e che, grazie all’AI, è sempre più in grado di contestualizzarli e interpretarli.
La trasformazione riguarda soprattutto gli OSS (Operations Support Systems), le piattaforme con cui operatori e team IT gestiscono servizi, risorse e performance di rete. Switch, router e collegamenti non diventano necessariamente “intelligenti” di per sé; è il livello software che li osserva, correla i dati e li governa ad acquisire capacità analitiche e decisionali sempre più avanzate.
In molti casi questo percorso non richiede una sostituzione radicale dell’infrastruttura esistente. L’automazione può partire dall’integrazione degli strumenti già presenti, dalla qualità dell’inventory e dalla disponibilità di dati telemetrici affidabili. Per trasformare le raccomandazioni generate dall’AI in azioni concrete servono però alcuni prerequisiti: API aperte e ben documentate, configurazioni coerenti, dati aggiornati e livelli di autorizzazione che garantiscano controllo e tracciabilità degli interventi.
Superare i silos: dall’alert al servizio aziendale
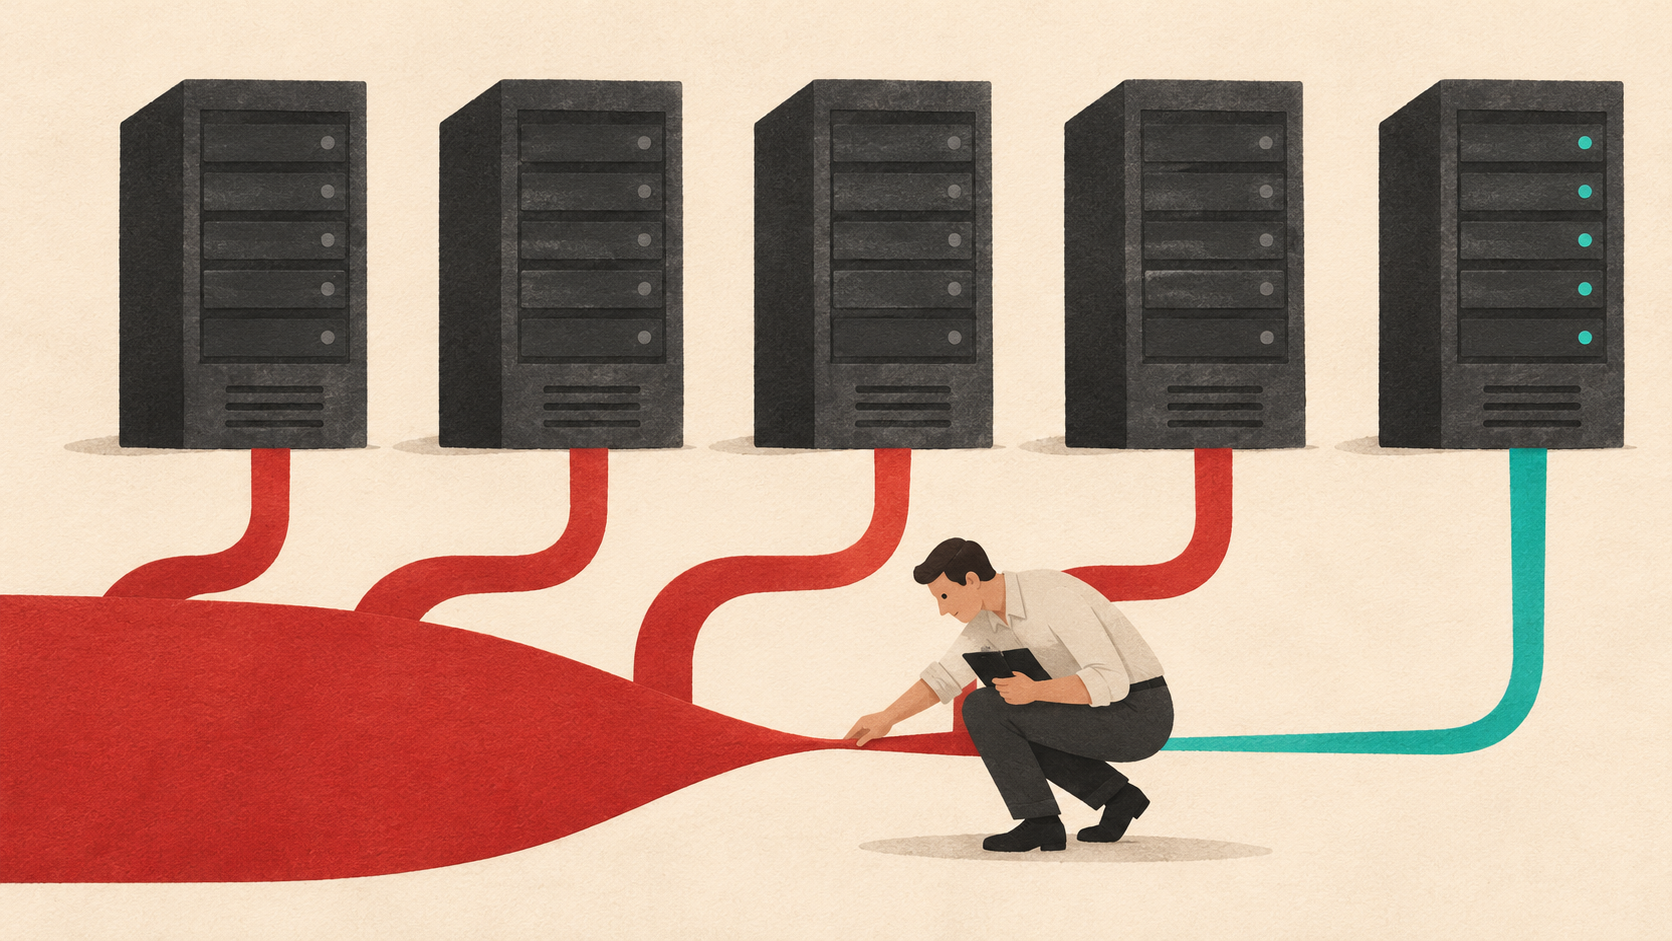
I team di networking operano spesso con strumenti separati per monitoraggio, inventory, provisioning e assistenza tecnica. Nel mondo delle telecomunicazioni, a questi si affiancano i BSS (Business Support Systems), che supportano attività commerciali, gestione dei clienti e fatturazione. La separazione storica tra OSS e BSS rende però complesso collegare un’anomalia tecnica al servizio effettivamente utilizzato dal cliente e al suo impatto sul business.
In questo senso, l’AI può contribuire a costruire una visione unificata delle informazioni disponibili. Un’anomalia rilevata su un router, ad esempio, può essere correlata a una recente modifica di configurazione, ai servizi che transitano attraverso quel nodo e ai ticket aperti dagli utenti. Il risultato è una diagnosi più contestualizzata e una più rapida individuazione delle possibili cause, pur senza eliminare la necessità di verifiche umane. L’efficacia dei modelli resta infatti legata alla qualità dei dati, alla correttezza dei permessi di accesso e alla conoscenza aggiornata delle dipendenze tra sistemi e servizi.
La telemetria di rete, naturalmente, non nasce con l’AI. Tecnologie come NetFlow e JFlow raccolgono da anni informazioni dettagliate sui flussi di traffico. La novità risiede nella capacità di correlare dati provenienti da fonti prima isolate, interpretarli in tempi molto più rapidi e dare priorità agli incidenti che hanno il maggiore impatto sulla continuità operativa e sull’esperienza del cliente.
L’accesso alle informazioni di rete sta cambiando in effetti il lavoro quotidiano dei team di rete. Oggi un tecnico può interrogare i sistemi in linguaggio naturale per sapere quali collegamenti risultino congestionati, da quali servizi dipenda un determinato apparato o quali anomalie si stiano ripresentando nel tempo. Quando è integrato con le piattaforme aziendali autorizzate, un AI agent può andare oltre la semplice consultazione: recuperare dati da più fonti, correlarli e avviare processi operativi, dalla richiesta di una nuova connettività all’apertura di un ticket o di un intervento tecnico.
Digital twin e Self-X: le tecnologie alla base delle reti autonome
Il digital twin simula l’impatto di guasti e nuove configurazioni
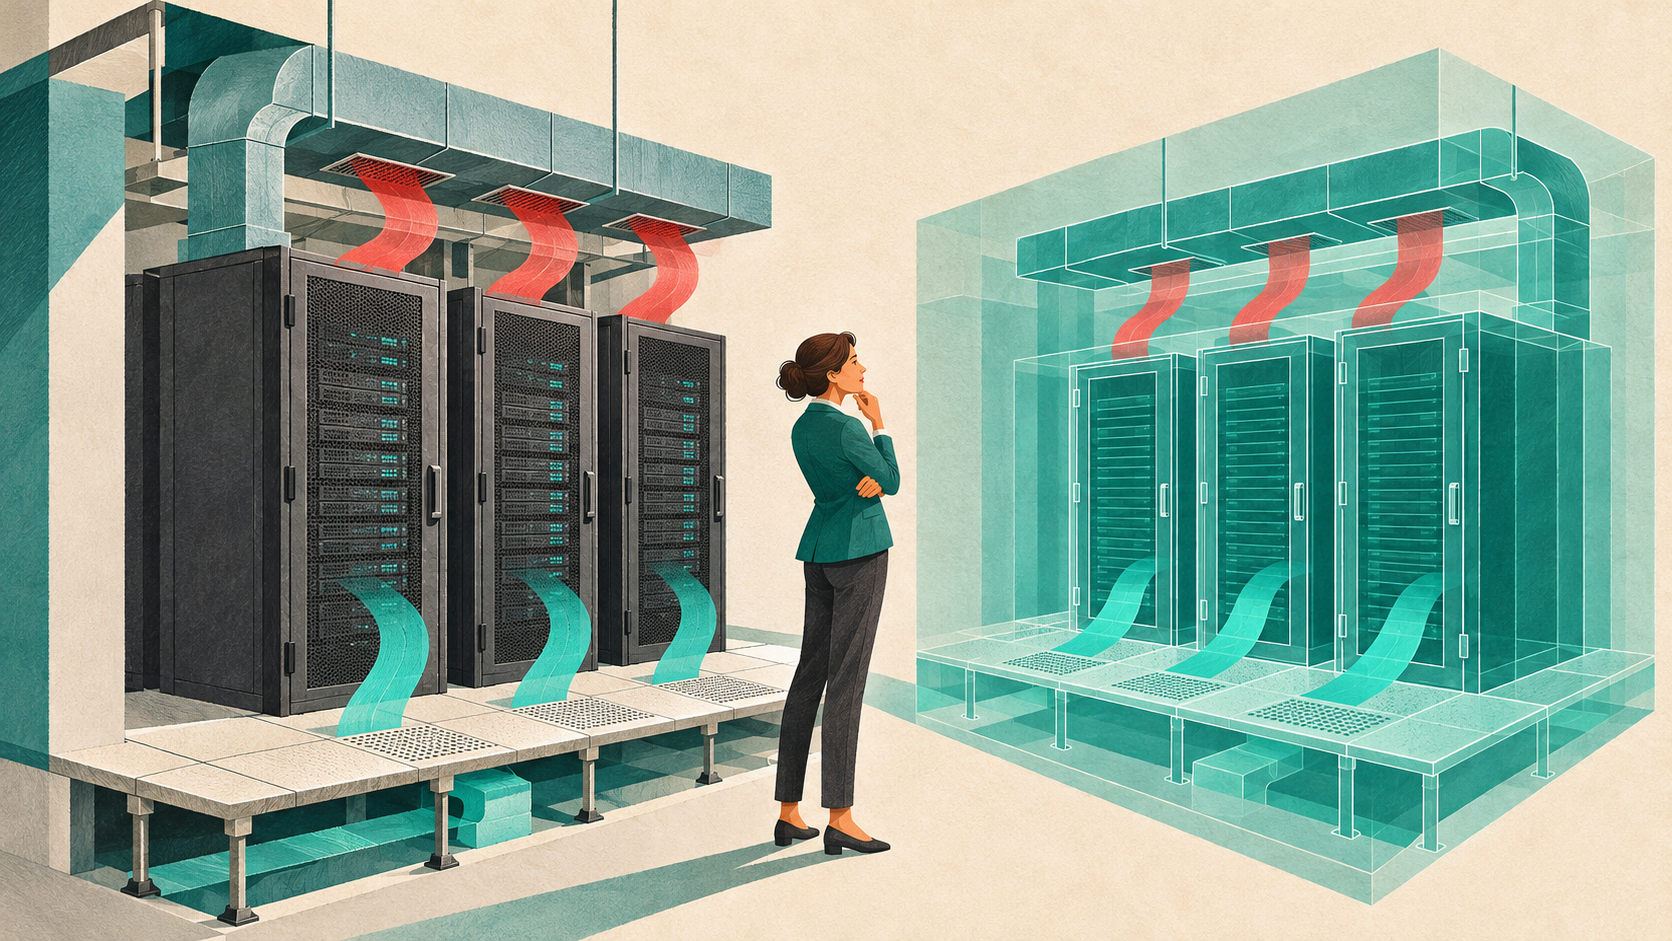
Un digital twin di rete è una rappresentazione virtuale dell’infrastruttura e del suo funzionamento, costruita combinando topologia, configurazioni, flussi di traffico e condizioni operative. Il suo valore sta nella possibilità di simulare scenari e valutarne gli effetti prima di intervenire sull’ambiente reale: cosa accadrebbe se un collegamento venisse interrotto, una cella radio raggiungesse la saturazione o il traffico aumentasse improvvisamente? Questi modelli supportano la pianificazione e consentono di generare dati utili anche per l’addestramento e la validazione degli algoritmi di AI, a condizione che il gemello digitale venga aggiornato in modo continuo e rifletta fedelmente lo stato della rete.
In Italia, ad esempio, TIM ha sviluppato un digital twin della propria rete di accesso radio che integra dati, configurazioni e simulazioni di copertura. L’obiettivo è supportare la progettazione e l’ottimizzazione della rete, oltre a fornire un ambiente controllato per l’addestramento e la validazione di algoritmi di AI prima del loro utilizzo in produzione.
Dalla rete che si monitora alla rete che si adatta
Se il digital twin consente di simulare il comportamento della rete e di valutare l’impatto di guasti, variazioni di traffico o nuove configurazioni, le funzionalità Self-X rappresentano il passo successivo: utilizzare queste conoscenze per automatizzare una parte delle attività operative.
Con l’espressione Self-X si indica l’insieme delle capacità che permettono a una rete di monitorarsi, configurarsi, ottimizzarsi e, in alcuni casi, correggersi autonomamente. Rientrano in questa categoria funzioni di self-monitoring, self-optimization e self-healing, introdotte progressivamente dagli operatori per ridurre gli interventi manuali e accelerare la gestione degli eventi.
Le quattro capacità Self-X
Rileva anomalie e cambiamenti di stato
Propone o applica azioni correttive consentite
Adatta risorse e configurazioni alle condizioni
Anticipa capacità e interventi futuri
In una rete mobile, ad esempio, un sistema può rilevare la congestione di una cella e ridistribuire parte del traffico verso celle vicine oppure modificare alcuni parametri entro limiti prestabiliti per mantenere la qualità del servizio. L’obiettivo non è solo reagire più rapidamente a un problema, ma anche prevenirlo. Quando la rete riesce a prevedere una situazione di congestione prima che si manifesti e ad allocare automaticamente le risorse necessarie, entrano in gioco modelli predittivi, dati affidabili e meccanismi di controllo sempre più evoluti.
È in questo passaggio, dalla simulazione alla decisione operativa e dalla reazione alla previsione, che prende forma il concetto di rete autonoma. Nella pratica, tuttavia, l’automazione riguarda soprattutto attività ripetitive e ben definite, mentre le operazioni con possibili impatti su disponibilità, sicurezza o continuità del servizio continuano generalmente a richiedere supervisione e approvazione umana.
Dove arriva l’autonomia: i livelli di TM Forum
Per capire quanto possa diventare autonoma una rete, TM Forum propone un percorso di maturità articolato in sei livelli, da 0 a 5. Il livello 4, definito highly autonomous, prevede gestione a ciclo chiuso basata su modelli AI, analisi predittive e apprendimento continuo per specifici servizi e processi.
La scala dell’autonomia di rete, da 0 a 5
Operazioni manuali
Assistenza e automazioni semplici
Automazione parziale
Autonomia condizionata, supervisione umana
Alta autonomia nei processi delimitati
Autonomia completa come obiettivo
La stessa TM Forum osserva che molti operatori si collocano fra i livelli 2 e 3, mentre alcuni raggiungono il 4 in singoli domini. La misurazione è quindi legata a uno scenario specifico — per esempio gestione dei guasti o ottimizzazione della qualità — e non autorizza a definire autonomo l’intero network di un’organizzazione.
Le attività che più facilmente si prestano a una gestione automatizzata sono quelle frequenti, osservabili e ripetibili:
- rilevazione degli incident e correlazione degli alert;
- diagnosi delle cause probabili e suggerimento del ripristino;
- ottimizzazione dei flussi di traffico e del routing;
- modifica di configurazioni entro policy prestabilite;
- previsione di guasti, domanda e fabbisogno di capacità;
- provisioning dei servizi e risposte di sicurezza routinarie autorizzate.
Le decisioni che devono restare sotto controllo umano
Più una decisione può produrre effetti estesi o irreversibili, maggiore deve essere il controllo. Architettura, investimenti e selezione dei fornitori coinvolgono compromessi di lungo periodo che non si risolvono con un algoritmo di ottimizzazione. Lo stesso vale per l’accettazione dei rischi, la conformità normativa, le politiche di sicurezza e le modifiche che potrebbero interrompere un servizio essenziale.
In questi casi il modello più realistico è una supervisione basata sul rischio: interventi routinari entro limiti preapprovati; escalation e approvazione esplicita per cambiamenti ad alto impatto; registri verificabili per ricostruire perché il sistema ha agito. Anche le modalità di rollback devono essere progettate e provate prima di affidare un processo all’automazione.
Se il network management evolve in questa direzione, cambia anche il lavoro del team IT. Gli specialisti non scompaiono: passano gradualmente dalla correzione manuale degli apparati al governo di modelli, dati, policy e automazioni. La rete diventa più capace di gestirsi, mentre l’organizzazione deve diventare più capace di governarla.




Partecipa alla community