


Nel 2026 la domanda vera per un CIO alle prese con i dilemmi legati all’integrazione dell’intelligenza artificiale nei processi aziendali non è più “utilizziamo o meno l’AI?”, ma piuttosto “dove la facciamo girare?”.
I pilot sono finiti, i modelli devono andare in produzione e il data center costruito per supportare le esigenze di applicazioni ERP e virtualizzazione comincia a mostrare tutti i suoi limiti: rack che chiedono dieci volte la potenza prevista, reti che diventano un collo di bottiglia, aria condizionata che non basta più… Un vero e proprio incubo per i direttori IT, che si accompagna al timore di dover litigare con il CFO per ingrandire stanze cablate e raffrescate, acquistare nuovi server, nuovi componenti di rete e storage.
La buona notizia è che una soluzione a questo problema c’è, e che ha un nome: AI factory.
Indice degli argomenti
Cos’è un’AI Factory: architetture e requisiti per il data center
Il termine, portato alla notorietà del pubblico dal CEO di NVIDIA Jensen Huang, descrive una fabbrica il cui prodotto non è acciaio ma intelligenza, misurata in termini di token generati. Non si tratta, quindi, semplicemente di un data center con qualche GPU in più, ma di un’infrastruttura pensata da zero per trasformare dati ed energia in valore di business, con calcolo, rete, storage e raffreddamento progettati come un unico sistema.
Per chi deve decidere investimenti da milioni di euro, capire come è fatta un’AI factory e cosa richiede è già una scelta strategica. Vediamo da dove partire.
Definizione e caratteristiche di un’AI factory
Una fabbrica di AI è un’infrastruttura di calcolo progettata end-to-end per l’intero ciclo di vita dell’intelligenza artificiale: ingestione e preparazione dei dati, addestramento e fine-tuning dei modelli, inferenza in produzione e, sempre più spesso, esecuzione di sistemi agentici.
Il punto chiave è l’approccio industriale. Calcolo accelerato, rete, storage, software di orchestrazione, alimentazione e raffreddamento vengono concepiti come un unico sistema integrato, ottimizzato per un solo obiettivo: produrre intelligenza in modo continuo, prevedibile ed efficiente.
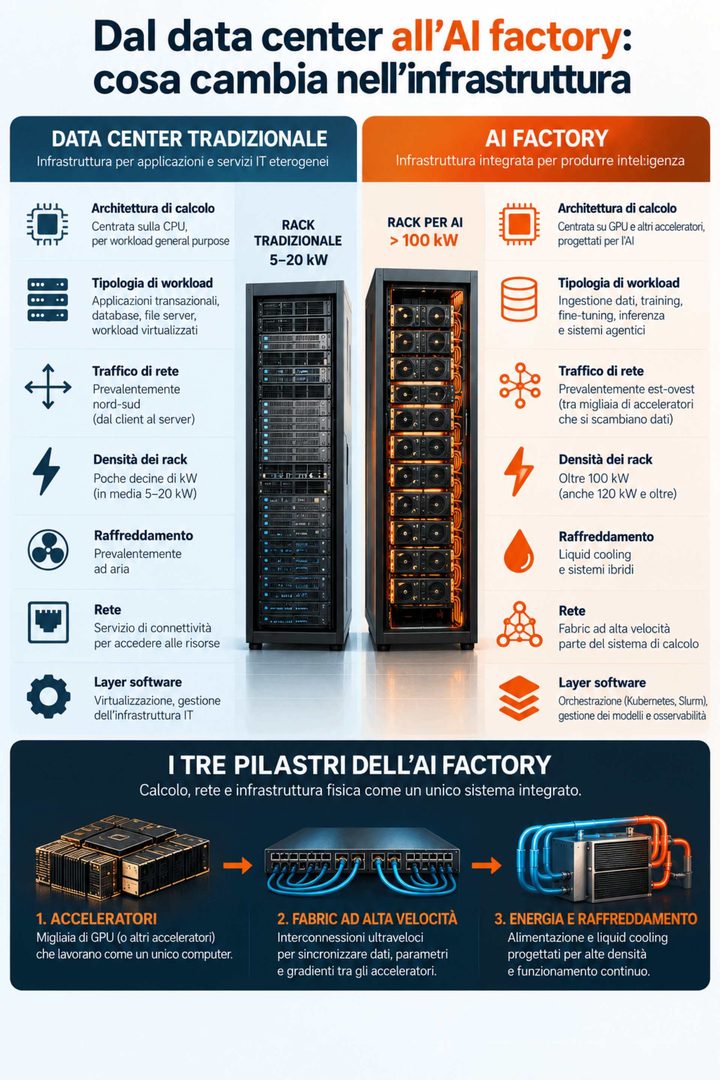
Tra le caratteristiche distintive c’è innanzitutto la centralità dell’acceleratore: le GPU (o altri acceleratori dedicati) diventano il cuore del sistema, non un componente opzionale. C’è poi la scala, perché i carichi di lavoro dell’AI generativa richiedono migliaia di acceleratori che ragionano come un unico computer. Infine, la densità: potenza e calore si concentrano in spazi ridotti, con impatti diretti su energia e progettazione fisica.
A queste si aggiunge un livello software (scheduling, orchestrazione con Kubernetes e Slurm, gestione dei modelli e osservabilità) che determina quanto del potenziale hardware si traduce in produttività reale.
Per comprendere la portata del cambiamento, conviene metterlo a confronto con ciò che i CIO conoscono meglio, ovvero il data center tradizionale.
Differenze tra data center tradizionale e AI factory
Il data center tradizionale nasce per ospitare carichi eterogenei e prevalentemente general purpose come applicazioni transazionali, database, file server, workload virtualizzati. Si tratta di un ambiente costruito attorno alla CPU, con reti dimensionate per il traffico “nord-sud” (dal client al server) e rack che, in media, assorbono poche decine di kilowatt al massimo, spesso anche molto meno. La parola d’ordine è flessibilità: molti carichi diversi, condivisi su risorse consolidate.
L’AI factory ribalta la prospettiva. Il carico è meno vario ma enormemente più intenso, ed è dominato da logiche “est-ovest”: migliaia di GPU che si scambiano continuamente parametri e gradienti durante l’addestramento.
I nuovi parametri che definiscono il successo della fabbrica dell’AI
La rete smette, quindi, di essere un servizio di connettività e diventa parte stessa del computer o del server. Anche la metrica di successo cambia: non più solo disponibilità e utilizzo delle risorse, ma throughput di token, tempo di addestramento e costo per inferenza.
Sul piano fisico, i rack per l’AI di ultima generazione possono superare i 100 kW ciascuno, un ordine di grandezza sopra le densità per cui la maggior parte delle sale dati è stata pensata. Il risultato è che spesso non basta “aggiungere qualche server GPU” a un’infrastruttura esistente perché potenza disponibile, cablaggio e raffreddamento vanno ripensati insieme.
Infrastruttura hardware e interconnessioni ad alta velocità
Se la GPU è il motore dell’AI factory, le interconnessioni ne sono il sistema nervoso. L’addestramento dei modelli di grandi dimensioni è un’operazione distribuita: il modello e i dati vengono suddivisi tra migliaia di acceleratori, che devono sincronizzarsi di continuo. Una GPU potentissima collegata a una rete lenta resta ferma ad aspettare e ogni ora di attesa è capitale immobilizzato. Per questo motivo, nella progettazione di una AI factory, il dimensionamento della rete è importante quanto la scelta degli acceleratori.
L’architettura si articola su più livelli di connessione. All’interno del singolo server e del singolo rack, tecnologie di interconnessione proprietarie ad altissima banda come NVLink di NVIDIA permettono a decine di GPU di comportarsi come un unico acceleratore di grandi dimensioni con memoria condivisa. Tra i rack e tra i nodi entra in gioco la rete di cluster, ed è qui che si concentrano le scelte più delicate per il CIO.
Cluster GPU, Fabric Network e InfiniBand
Un cluster GPU per l’AI è tipicamente organizzato in “scalable unit” replicabili, collegate da un fabric network, cioè una rete a topologia non bloccante (spesso di tipo fat-tree o rail-optimized) progettata per garantire banda uniforme tra qualsiasi coppia di nodi.
L’obiettivo è eliminare la congestione e ridurre al minimo latenza e variabilità, perché nelle operazioni collettive la velocità dell’intero cluster è dettata dal collegamento più lento.
Per anni lo standard de facto per questi ambienti è stato InfiniBand, tecnologia nata nel mondo dell’high performance computing e caratterizzata da bassa latenza, controllo di flusso nativo senza perdita di pacchetti e capacità di calcolo “in-network” per accelerare le operazioni collettive. Le generazioni più recenti raggiungono velocità per porta di 400 e 800 Gb/s.
Accanto a InfiniBand si sta, però, consolidando l’alternativa Ethernet ottimizzata per l’AI: NVIDIA propone la piattaforma Spectrum-X, mentre l’Ultra Ethernet Consortium lavora a specifiche aperte pensate per i carichi di lavoro di intelligenza artificiale e HPC.
Come evitare il vendor lock-in
Per un CIO la scelta non è puramente tecnica. Pesano, infatti, l’ecosistema di fornitori, le competenze già presenti in azienda, il rischio di lock-in tecnologico e il costo totale di gestione. Una regola pratica è progettare la rete insieme agli acceleratori e ai carichi previsti, evitando di trattarla come un elemento da definire in seconda battuta.
A tutto questo si affianca un capitolo spesso sottovalutato, quello dello storage e della gestione dei dati: file system paralleli e storage ad alte prestazioni devono alimentare le GPU senza interruzioni, perché un acceleratore che aspetta i dati è un investimento che non rende.
Gestione termica ed energetica per le AI factory
Ma anche il miglior fabric di rete, alla fine, deve fare i conti con un vincolo fisico legato a energia e calore.
La densità di potenza è la vera linea di demarcazione tra il data center di ieri e la AI factory di oggi. Ogni watt assorbito da una GPU diventa calore da smaltire e quando un singolo rack supera il centinaio di kilowatt le soluzioni tradizionali di raffreddamento ad aria mostrano i loro limiti. Per il CIO, la questione si traduce in tre domande molto pratiche: quanta potenza è disponibile oggi nel sito, quanta ne servirà tra tre o quattro anni e con quale efficienza sarà possibile dissiparla.
Sul fronte energetico, l’AI factory impone di ragionare in termini di megawatt e non più di kilowatt. Connessione alla rete elettrica, distribuzione interna, sistemi di continuità, gestione dei picchi di carico tipici dell’addestramento… Entrano in gioco, qui, anche la sostenibilità e la conformità normativa, con indicatori come il PUE (Power Usage Effectiveness), il riutilizzo del calore di scarto e l’approvvigionamento da fonti rinnovabili, temi ormai centrali nelle strategie ESG e nelle valutazioni di conformità europee sull’efficienza dei data center.
Pianificare capacità elettrica e raffreddamento con largo anticipo è spesso ciò che distingue un progetto che parte in tempo da uno che resta bloccato per mancanza di potenza.
Raffreddamento a liquido direct-to-chip
Tra le soluzioni oggi più diffuse per gestire queste densità c’è il raffreddamento a liquido direct-to-chip. Il principio è semplice: invece di spostare enormi volumi d’aria attorno ai componenti, un liquido refrigerante circola in piastre fredde (cold plate) montate direttamente a contatto con GPU e CPU, assorbendo il calore alla fonte.
Il liquido, grazie alla sua capacità termica molto superiore a quella dell’aria, trasporta molto più calore con molta meno energia. Il circuito primario del rack si collega poi a unità di distribuzione del refrigerante (CDU) e a un anello idraulico che porta il calore all’esterno, dove può essere dissipato o, in scenari più evoluti, recuperato per altri usi come il teleriscaldamento.
Per i CIO i vantaggi sono tre: la possibilità di supportare densità di rack altrimenti irraggiungibili, un miglioramento dell’efficienza energetica complessiva (e quindi del PUE) e una maggiore stabilità termica degli acceleratori, con benefici sulle prestazioni.
Restano, però, impatti da valutare con attenzione come la necessità di impianti idraulici all’interno della sala dati, la formazione del personale, la compatibilità con i server scelti e il fatto che, nella maggior parte delle implementazioni, una quota di calore venga ancora gestita ad aria, dando origine ad architetture ibride.
Per chi ha un data center già in funzione, la domanda strategica è se adattarlo con un approccio di tipo retrofit, costruire nuove sale dedicate o affidarsi a provider di colocation che già adottano il liquid cooling.
I tre pilastri della factory dell’IA
In definitiva, un’AI factory si costruisce su un equilibrio tra tre ingredienti: acceleratori, rete e infrastruttura fisica. Trascurarne uno significa compromettere il ritorno degli altri.
Per il CIO, il primo passo è tradurre le ambizioni di business in requisiti misurabili (carichi, scala, tempi) e da lì risalire a potenza, rete e raffreddamento, coinvolgendo fin dall’inizio facility management, energy management e CFO.
Chi lo farà con metodo potrà trasformare l’AI da sperimentazione a vera e propria capacità industriale, con una fabbrica capace di produrre intelligenza in modo affidabile e sostenibile nel tempo.





Partecipa alla community